Ollama+Open WebUIを8GBのVPSで実測|GPUなしの日本語生成は「1秒に数文字」【2026年版】
2026-10-14
※2026年10月7日時点の情報です。Ollama 0.40.0 と Open WebUI v0.11.4 を弊社の検証サーバーで計測しました。速度はモデル・設定・サーバーで変わります。
「ChatGPT の代わりに自社サーバーで AI チャットを動かしたい」と調べると、Ollama(モデルを動かすエンジン)と Open WebUI(ChatGPT 風の画面)の組み合わせが定番です。ただ、手順の記事は多いのに、GPU のない普通の VPS でどのくらいの速さで日本語が返るかを数字で書いた記事はほとんどありません。そこで弊社で、さくらのクラウドの 2コア・メモリ8GB・SSD 40GB(GPU なし)に Docker で両方を入れ、3つの小型モデルで日本語の生成速度を測りました。
結論:8GB・GPUなしのVPSでもOllama+Open WebUIは動く。ただし日本語は「1秒に数文字」
- 3〜4B(30〜40億パラメータ)のモデルなら 8GB に収まる。生成中のメモリ使用量は 3.9〜5.0GB
- 生成速度は 4〜5トークン/秒。体感は「1秒に数文字ずつ」で、300字程度の回答に 1〜2分
- Open WebUI の画面から使うと、API を直接叩くよりさらに遅い(既定設定が CPU 環境に向いていない)
- 日本語の自然さは gemma3:4b が最も良い。llama3.2:3b は意味の通らない箇所があり、qwen3:4b は思考が終わらず回答に至らなかった
実測:3モデルの日本語生成速度・メモリ・読み込み時間
Ollama の API(/api/generate)に直接、同じ質問「中小企業の社内問い合わせ向け AI チャットボットのメリットと注意点を300字で」を送り、出力上限 400トークン、モデルは1つずつ単独で読み込みました。
| モデル | サイズ | 読み込み | 生成速度 | 日本語の文字/秒 | 全体の所要時間 | 生成中のメモリ使用量 |
|---|---|---|---|---|---|---|
| llama3.2:3b | 2.0GB | 11.7秒 | 5.45 tok/s | 8.5 | 87秒(620字) | 3.9GB |
| qwen3:4b | 2.5GB | 26.7秒 | 4.26 tok/s | 16.6(英語の思考文が混ざる) | 123秒 | 4.4GB |
| gemma3:4b | 3.3GB | 45.1秒 | 4.07 tok/s | 7.9 | 112秒(503字) | 5.0GB |
qwen3:4b の文字/秒が大きいのは、回答の前に英語の思考文が入ったためです。読み込みにも注意が必要で、モデルを切り替えるたびに 10〜45秒かかります。Ollama は使い終わったモデルを5分後にメモリから解放するため(公式 FAQ)、間を空けると再び読み込みが起きます。gemma3:4b の後に qwen3:4b を選ぶと両方がメモリに載り(3.2GB+2.9GB)、空きは 3.1GB まで減りました。8GB では2モデルの同時読み込みで余裕がなくなります。
Ollama の README には以前「7B のモデルには少なくとも 8GB の RAM」と書かれていました(現在は削除)。今回の 3〜4B で 3.9〜5.0GB でしたので、8GB の VPS で現実的なのは 4B 前後までです。
Open WebUI経由だとさらに遅くなる理由
Open WebUI の画面から同じ質問をすると、qwen3:4b の生成中の速度は 2.57 tok/s(API 直接なら 4.26 tok/s)まで落ちました。理由は3つあります。
- 質問の前に長い前置きが送られる:v0.11 はツール呼び出しの定義を含む 2,000トークン超のシステムプロンプトをモデルに渡します。2コア CPU の前処理は約25トークン/秒なので、生成が始まる前に80秒以上かかります
- モデルが裏で何度も呼ばれる:チャットのタイトル、関連質問、タグの自動生成のたびにモデルを呼びます。公式ドキュメントによれば、既定ではチャットと同じモデルを使います
- 長いコンテキストで生成も遅くなる:前置きの分だけ処理する文脈が増えます
llama3.2:3b を Open WebUI から使うと、生成中は 5.2 tok/s でも、送信から回答完了までは約2分でした。
導入手順とつまずいた点(ディスク満杯・ツール非対応・英語画面)
導入は公式ドキュメントのとおり Docker で動きます。弊社は ollama/ollama と ghcr.io/open-webui/open-webui:main を Docker Compose で起動し、どちらも 127.0.0.1 だけに公開して SSH トンネル経由で確認しました(イメージ取得 168秒、応答まで 220秒)。つまずいた点は3つです。
| つまずき | 何が起きたか | 対処 |
|---|---|---|
| ディスク 40GB が満杯 | Ollama イメージ 9.4GB+Open WebUI イメージ 6.5GB で約16GB。別の OSS と同居した状態でモデルを取得したら「no space left on device」 | 使わない OSS のイメージを削除して 13GB 空けた。最終的にモデル3つ(7.8GB)込みで 29GB/40GB |
| gemma3 がツール非対応で回答しない | gemma3:4b に送ると「does not support tools」と出て回答なし | モデル設定で Function Calling を切るか、ツール対応の llama3.2・qwen3 を選ぶ |
| 初期画面が英語、翻訳の崩れ | 歓迎画面は英語。v0.11.4 の設定画面は見出しが「settings.personal.general.title」のような翻訳キーの生表示だった | 「設定 → 一般 → 言語」で日本語へ(約60言語)。切替後も一部の見出しと提案カードは英語のまま |
ディスクには公式の :slim イメージ(1.66GB → 176MB、取得時)が有効です。Ollama とチャットするだけなら slim で足ります。ツール非対応のエラーは、Open WebUI が v0.10.0 からモデル自身の関数呼び出し(Native モード)を既定にしたためで、Ollama のモデルページに「tools」の表示がないモデルはそのままでは回答できません。
回答の質:gemma3が最も自然、llama3.2は浅く、qwen3は思考が終わらない
- gemma3:4b:見出し付きで最も自然な日本語。ただし読み込みが最も遅く(45秒)、Open WebUI ではツール設定の変更が必要
- llama3.2:3b:読める日本語だが内容が浅い。「人件費を削減することで、収益を拡大」「技術の update すると効果が低下します」など意味の通らない箇所があった
- qwen3:4b:思考型のため、Open WebUI では「思考中…」のまま4分で思考が521トークンに達しても回答に至らず停止。API で
think: falseを指定しても英語の思考文から始まった(原因は未確認)
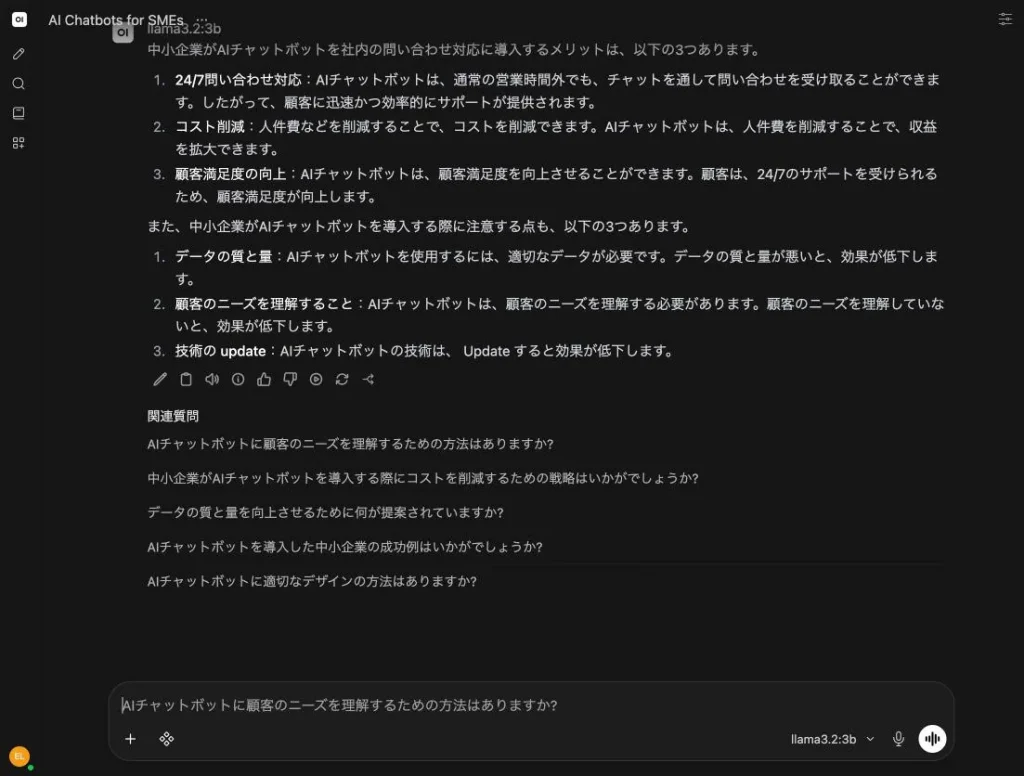
画像3は llama3.2:3b の回答です。「関連質問」5件は日本語で自動生成された一方、チャットのタイトルは「AI Chatbots for SMEs」と英語でした。社内で使うなら、回答を人が確認する用途(下書き・要約・言い換え)に絞るのが現実的です。
8GBのCPU VPSで実用にするなら
- 裏の自動生成を切る:「設定 → 管理者 → インターフェース」でタイトル生成・タグ生成・フォローアップ生成・オートコンプリートを無効にする(環境変数なら
ENABLE_TITLE_GENERATIONなどを false)。公式も、弱いハードウェアではオートコンプリートを最初に切ることを勧めています - タスク用モデルを分ける:自動生成を残すなら「Local Task Model」に 1B 前後の小さなモデルを指定する
- モデルは1つに絞り、思考型を避ける:ツール対応で読み込みの速い llama3.2:3b か、日本語重視なら gemma3:4b(ツールを切る)
それでも「1秒に数文字」は変わりません。本気で使うなら、Ollama は GPU のあるマシンか手元の Mac に置き、VPS には Open WebUI だけを置く構成が妥当です。Open WebUI 自体は軽く(起動直後のサーバー全体で約1.3GB、うち素の OS が 0.54GB)、Ollama の接続先は URL で指定できます。
Ollama+Open WebUIのVPS運用が向いている人・向いていない人
| 向いている | 向いていない |
|---|---|
| 社内データを外に出さずに、要約・下書きを数人で試したい | ChatGPT と同じ速さ・賢さを期待している |
| 夜間バッチなど、待ち時間が気にならない用途 | 複数人が同時に質問する(CPU では1人分でも遅い) |
| GPU や Mac を別に用意でき、VPS は画面だけにしたい | 日本語の回答をそのまま顧客対応に使いたい |
商用ではライセンスにも注意が必要です。Open WebUI は BSD-3 条項に独自の第4条を加えたライセンスで、直近30日のエンドユーザーが50人を超える環境では、書面許可かエンタープライズライセンスなしに「Open WebUI」の名称・ロゴを変更・削除できません。OSSMatch ではこの条件から「ソース公開型」に分類しています。社内50人以下なら影響しませんが、自社ブランドの画面として顧客に提供するなら事前に確認してください。Ollama 自体は MIT ライセンスです。
まとめ:8GBのVPSは「試す」には十分、「使う」にはGPUか分離構成を
- 2コア・8GB・GPU なしの VPS で、3〜4B のモデルはメモリ 3.9〜5.0GB で動く
- 日本語の生成は 4〜5トークン/秒。300字の回答に 1〜2分
- Open WebUI の既定設定(ツール呼び出し・タイトル生成・関連質問)が CPU では足を引っ張る。管理画面で切る
- 実用にするなら、推論は GPU か Mac に置き、VPS には Open WebUI だけを置く
両ソフトの概要と ChatGPT との費用の違いは OSSMatch にまとめています。
サーバー選定や GPU と VPS を分ける構成の設計が不安な場合は、合同会社Edel Hearts のOSS導入支援でご相談を受け付けています。
出典
- Open WebUI Docs:Quick Start(Docker の起動コマンド、slim イメージ 176MB/1.66GB)(2026年10月7日確認)
- Open WebUI Docs:Essentials(Native モードが既定、バックグラウンドタスクがチャットモデルを使う、オートコンプリートを切る推奨)(2026年10月7日確認)
- Open WebUI Docs:Task Models(タイトル・タグ・フォローアップ・オートコンプリートの設定と環境変数)(2026年10月7日確認)
- Open WebUI Docs:Tools(Native が v0.10.0 から既定、モデルごとの Function Calling 設定の場所)(2026年10月7日確認)
- Open WebUI LICENSE(第4条:30日・50人のブランド条項)(2026年10月7日確認)
- Ollama LICENSE(MIT)(2026年10月7日確認)
- Ollama Docs:FAQ(モデルは5分でメモリから解放、OLLAMA_MAX_LOADED_MODELS の既定は CPU で3)(2026年10月7日確認)
- Ollama Docs:Thinking(think パラメータ)(2026年10月7日確認)
- Ollama README(v0.5.0 時点):7B に 8GB、13B に 16GB の RAM(2026年10月7日確認。現在の README からはこの記述は削除されている)
- Ollama Library:gemma3(4b は 3.3GB、tools 表示なし)(2026年10月7日確認)
- Ollama Library:qwen3(4b は 2.5GB、tools・thinking 対応)(2026年10月7日確認)
- Ollama Library:llama3.2(3b は 2.0GB、tools 対応)(2026年10月7日確認)
▶ 同じ環境で測った他の OSS は OSS 実機検証シリーズの一覧 にまとめています。