Paperless-ngxの日本語OCRを実測|請求書・領収書の読み取り精度と処理時間【2026年版】
2026-10-30
※2026年10月25日時点の情報です。弊社のサーバーで Paperless-ngx v3.3.4 を動かし、検証しました。OCR の精度は書類の作りや画質に大きく左右されます。設定項目や既定値も版によって異なるため、最新の内容は公式ドキュメントをご確認ください。
紙の請求書や領収書、管理組合のお知らせをスキャンし、あとから文字で検索したい。こうした用途のセルフホスト型書類管理ツールとして挙がるのが Paperless-ngx です。ただし、OCR(画像の文字読み取り)は英語を前提としており、日本語の書類をどこまで正しく読めるのかを数値で紹介した記事はほとんど見当たりません。そこで弊社では、2コア・8GB の VPS に Docker で v3.3.4 を構築。日本語のテスト書類6枚を使って、読み取り精度と処理時間を測定しました。
結論:Paperless-ngxの日本語OCRは「探す」には十分、「転記」には使えない
- 6枚の日本語 OCR 一致率は90.8〜99.4%。最も正確に読めたのは明朝体の文章だった
- 処理時間は1枚あたり4.3〜5.3秒。取り込みから検索可能になるまでは全体で6〜9秒
- 「排水管」「サンプル商事」「84,700」など、日本語・数字での検索では試した12語すべてで該当の2枚がヒットした
- ただし金額のカンマがピリオドに変わる(33,000円 → 33.000円)。請求書・領収書のほぼ全部の金額で発生した
- 本文にある「2026年10月20日」のような日本語の日付は読み取られず、作成日には取り込み日が入った
- メモリの増分は 1GB 未満(webserver 795MB)。一方、Docker イメージの容量は約3.6GB
今回のテスト書類はすべて架空です。弊社がフォントを使って作成した画像であり、実在の請求書やレシートは使用していません。サンプル数も6枚に限られるため、数値は「傾向を見る目安」として捉えてください。
Paperless-ngx v3.3.4 の検証環境と、日本語OCRのために変えた設定
検証には、さくらのクラウドの2コア・メモリ8GB・SSD 40GB(Ubuntu 22.04、Docker 29.8.2)のサーバーを使いました。公式リポジトリにある docker/compose/docker-compose.postgres.yml と docker-compose.env(main ブランチ)をそのまま使用し、変更は次の点に絞っています。
| 変更した点 | 公式ファイルの既定 | 弊社の設定 |
|---|---|---|
| ポートの公開範囲 | "8000:8000"。サーバーの全アドレスで 8000 番が開く。Docker が開けたポートは ufw では止められない |
"127.0.0.1:8000:8000" に変更 |
| OCR の言語 | 公式ドキュメントによると、PAPERLESS_OCR_LANGUAGE の既定は eng(英語) |
PAPERLESS_OCR_LANGUAGE=jpn+eng |
| 追加する言語データ | 既定で含まれるのは英語・ドイツ語・イタリア語・スペイン語・フランス語。日本語は含まれない | PAPERLESS_OCR_LANGUAGES=jpn。起動時に日本語データが入り、tesseract --list-langs に jpn が表示されることを確認 |
| そのほか | ― | PAPERLESS_SECRET_KEY(生成値)・PAPERLESS_TIME_ZONE=Asia/Tokyo・PAPERLESS_URL・管理者ユーザーを追加 |
日本語で利用する際は、まず OCR の言語に関する2つの設定が必須です。PAPERLESS_OCR_LANGUAGE は「どの言語で読むか」を、PAPERLESS_OCR_LANGUAGES(末尾に S)は「どの言語データを入れるか」を指定します。よく似た名前なので、取り違えないよう注意してください。OCR エンジンは tesseract 5.5.0 でした。また、公式ドキュメントでは、言語を複数指定すると CPU 時間が増えると説明されています。
起動時間とメモリ
| 項目 | 実測値 |
|---|---|
| Docker イメージ | paperless-ngx 3.59GB・postgres:18 650MB・valkey 66MB。取得に 55秒 |
| 起動時間 | up -d からログイン画面が 200 を返すまで 56秒 |
| メモリ(起動60秒後) | 全体 used 1.1GB(増分 851MB)。内訳は webserver 795MB・db 52MB・broker 9MB |
| 書類8枚の取り込み後 | webserver 804MB。ほとんど変化なし |
| ディスクの増加 | 4.1GB(ほぼイメージ) |
メモリの増分は 1GB 未満に収まっており、8GB はもちろん、2GB のサーバーでも動作する見込みです。ただし、OCR の処理中には CPU を使います。
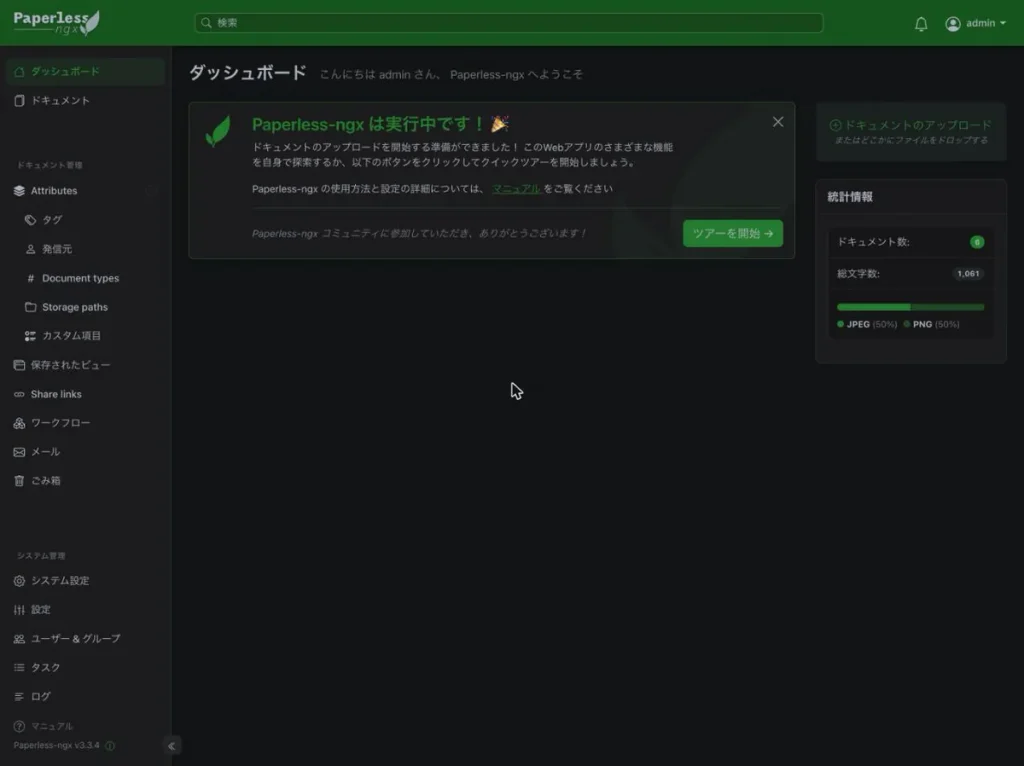
ブラウザの言語に合わせ、画面は日本語で表示されました。一方、左メニューの「Attributes」「Document types」「Storage paths」「Share links」は英語のままでした。
テスト書類と、OCR一致率の計算方法
テストには、弊社で作成した架空の書類3種類を使っています。各書類に「きれい」と「スキャン風」の2枚を用意し、合計6枚を API で1枚ずつ取り込みました。
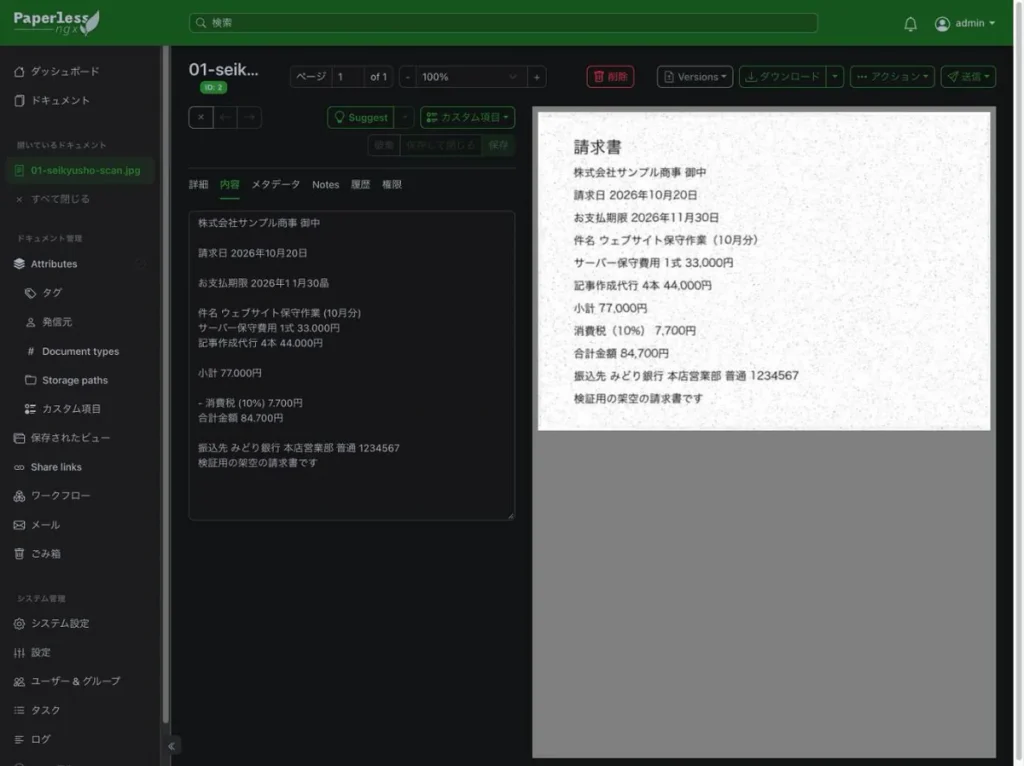
- 請求書:ゴシック体(ヒラギノ角ゴ)。金額・振込先・期限を記載
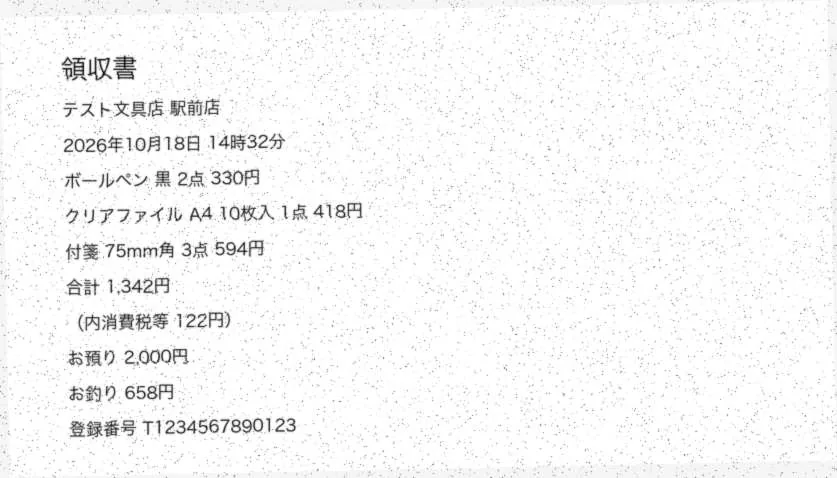
- 領収書:ゴシック体。レシートのように短い行と数字が多い構成
- お知らせ:明朝体。マンション管理組合による排水管清掃の案内文
きれい版は、A4 幅で約200dpi 相当の PNG としました。スキャン風は、約100dpi に縮小して1.2度傾け、ノイズとぼかしを加えたうえで JPEG(品質60)で保存しています。家庭用スキャナーやスマホで雑に撮った書類を想定したものです。
一致率は、正解テキストと OCR 結果の双方から空白を取り除き、NFKC 正規化(全角・半角などの表記ゆれをそろえる処理)を行ってから、一致した文字数を正解の文字数で割った値です。改行や空白の入り方は違いとして数えず、文字の誤読と抜けだけを対象にしています。
実測:Paperless-ngxの日本語OCR一致率(請求書・領収書・お知らせ)
| 書類 | 正解の文字数 | 一致率 |
|---|---|---|
| 請求書(きれい・ゴシック) | 163字 | 90.8% |
| 請求書(スキャン風) | 163字 | 94.5% |
| 領収書(きれい・ゴシック) | 126字 | 98.4% |
| 領収書(スキャン風) | 126字 | 96.0% |
| お知らせ(きれい・明朝) | 164字 | 99.4% |
| お知らせ(スキャン風・明朝) | 164字 | 98.2% |
最も正確に読み取れたのは明朝体の文章(お知らせ)で、スキャン風でも一致率は 98.2% でした。一方、表のように短い行や数字が多い書類ほど、読み取りが崩れています。
意外にも、請求書はきれい版(90.8%)のほうがスキャン風(94.5%)より低い結果になりました。きれい版にだけ「円」の読み違いと「本店営業部」の誤読が生じたためです。画質が良いほど必ず正確に読める、とは限りません。ただし、サンプルは6枚なので、この差を一般的な傾向とすることはできません。
読み違いの傾向:カンマ・「円」・大きな見出し
正解と OCR 結果を1行ずつ照らし合わせたところ、読み違いが起きる箇所には偏りが見られました。
| 読み違い | 正解 → OCR 結果 | 発生した書類 |
|---|---|---|
| 金額のカンマがピリオドに | 33,000円 → 33.000円、84,700円 → 84.700円 | 請求書・領収書のほぼ全部の金額 |
| 「円」が別の字に | 33,000円 → 33.000由、44,000円 → 44.000幅 | 請求書(きれい)で3か所 |
| 漢字がアルファベットに | 本店営業部 → ABER | 請求書(きれい) |
| 大きな見出しの欠落 | 「請求書」が丸ごと抜ける | 請求書の2枚とも |
| 日付の崩れ | 11月30日 → 1 1月30晶 | 請求書(スキャン風) |
| 形の似た字 | テスト文具店 → デスト文具店、黒 → 時、3点 → 35 | 領収書(スキャン風) |
| 熟語・曜日 | 清掃 → 消電、(木)→ (Ad) | お知らせ(スキャン風) |
とりわけ困るのが金額のカンマの誤読です。人が見れば「33.000円」の意味は分かりますが、表計算ソフトや会計ソフトに貼り付けると、「33円」のような小数として扱われるおそれがあります。書類の種類を示す、最も大きな見出し「請求書」が抜けた点にも注意が必要です(文字の大きさが他の行の約1.5倍)。それでも「請求書」の検索でヒットしたのは、本文にある「検証用の架空の請求書です」の行を読み取れていたためとみられます。
こうした結果から、金額や日付の正確さが求められる用途(経理への転記など)では、OCR 結果をそのまま利用できません。一方、あとから書類を検索するための文字情報としては、十分な精度がありました。なお、電子帳簿保存法などの保存要件を満たすかどうかは、今回の検証対象に含めていません。
処理時間:1枚4.3〜5.3秒、画質の差はほぼなし
API で6枚を1枚ずつ取り込み、それぞれのタスクの処理時間を記録しました。
- OCR を含むタスクの処理時間:1枚あたり 4.3〜5.3秒
- 取り込みから検索が可能になるまで:全体で6〜9秒
- きれい版とスキャン風の差:ほぼなし
1ページの書類であれば、2コアの CPU でこの速さでした。今回取り込んだのは1ページずつの書類なので、数十ページの PDF や数百枚を一括で取り込む場合の所要時間は測定していません。
日本語で書類を検索できる? 試した12語はすべてヒット
取り込み後の書類を、全文検索と、タイトルと本文の部分一致検索という2通りの方法で探しました。
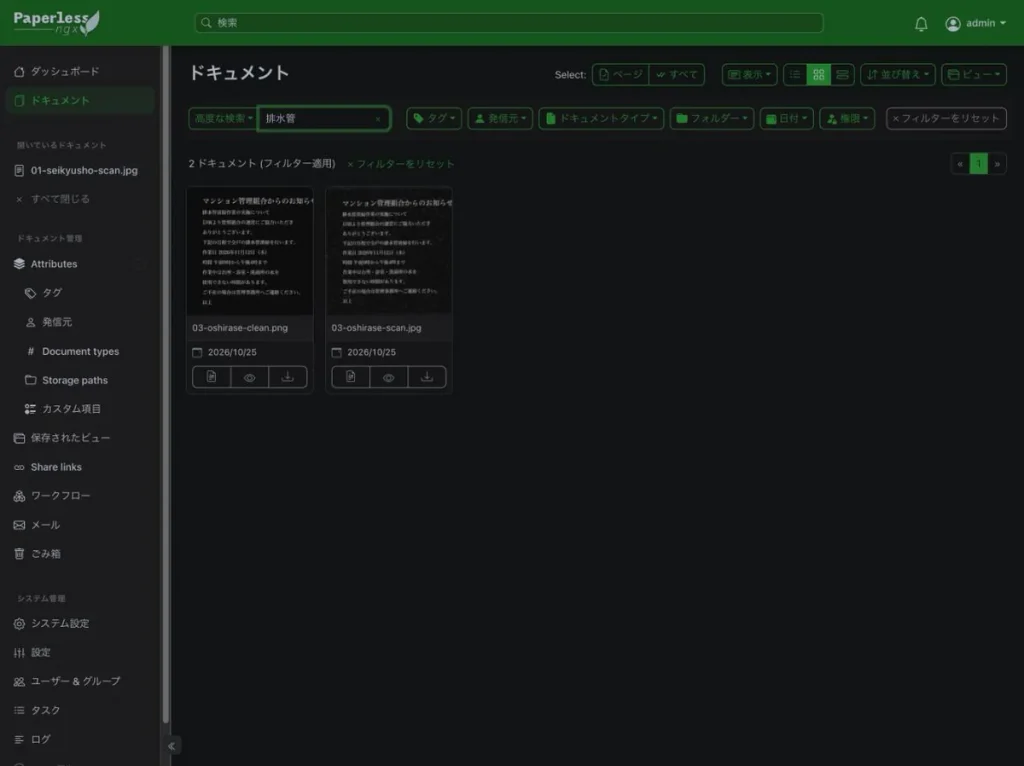
検索に使ったのは「排水管」「排水管清掃」「清掃」「サンプル商事」「株式会社サンプル商事」「クリアファイル」「領収書」「請求書」「管理組合」「保守」「84,700」「1234567」の12語です。すべての語で該当の2枚(きれい・スキャン風)がヒットし、部分一致検索でも結果は変わりませんでした。
スキャン風のお知らせでは、本文の「排水管清掃を行います」にある「清掃」が「消電」と誤読されていました。それでも検索にヒットしたのは、同じ書類の別の行(「排水管清掃作業の実施について」)を正しく読み取れていたためです。つまり、書類の中に同じ言葉が何度かあれば、1か所を読み違えても見落としにくいと言えます。一方、1回だけ登場する言葉を誤読すると、その言葉で検索しても見つからない可能性があります。
書類の日付:日本語の日付は読み取られず、取り込み日になった
Paperless-ngx には、本文から日付を探し出して書類の「作成日」に設定する機能があります。ところが今回は、本文に記載した「2026年10月20日」のような日本語の日付を読み取れず、取り込んだ8枚すべてで、作成日が取り込み日(2026-10-25)になりました。
日付を読む言語の指定として PAPERLESS_DATE_PARSER_LANGUAGES=ja を追加し、新たに取り込み直しても結果は変わりませんでした。書類によっては日付の文字自体を OCR で正しく読めていたため、文字の読み取りよりも、日付として拾う処理に問題があるとみられます。日本語の書類を日付で整理するには、作成日を手で修正するか、ファイル名やワークフローで付ける運用が必要になります。
Paperless-ngxの日本語OCRが向いている人・向いていない人
| 向いている | 向いていない |
|---|---|
| 紙の書類をスキャンし、あとから日本語で検索したい | OCR 結果にある金額や日付を、そのまま会計ソフトへ転記したい |
| お知らせ・案内文など、文章の書類が多い(明朝体で 98〜99%) | レシートのように短い行と数字ばかりの書類を正確に読み取りたい |
| 書類のデータは自分のサーバーに置きたい。Docker と SSH に抵抗がない | 作成日を自動で付け、日付順に並べたい。日本語の日付は取り込み日になった |
| 小規模なサーバーで動かしたい(メモリの増分は 1GB 未満) | ディスクの空きに余裕がない。イメージだけで約3.6GB を使う |
弊社としての結論は、「探すための OCR には使えるが、読み取った数字は信用しない」です。利用する際は、金額や日付を元の画像で確認することを前提にしてください。
まとめ:Paperless-ngxの日本語OCRは一致率90.8〜99.4%、弱点は数字と日付
- Paperless-ngx v3.3.4 で日本語 OCR を利用するには、
PAPERLESS_OCR_LANGUAGE=jpn+engとPAPERLESS_OCR_LANGUAGES=jpnの2つの設定が必要 - 架空の書類6枚で一致率は 90.8〜99.4%。最も正確なのは明朝体の文章で、短い行と数字が多い書類ほど読み取りが崩れる
- 1枚の処理時間は 4.3〜5.3秒。日本語検索では、試した12語のすべてでヒット
- 金額のカンマがピリオドに変わる、大きな見出しが欠ける、日本語の日付が作成日に反映されない
- 公式の compose ではポート 8000 が全公開になる。
127.0.0.1に限定するか、リバースプロキシを前に配置する - サンプルは6枚で、1ページずつ。実在の書類、手書き、複数ページの PDF、大量取り込みについては未検証
OSSMatch では、Paperless-ngx の概要や、Evernote などの代わりになる OSS を紹介しています。
「自社の書類で日本語 OCR がどこまで使えるか試したい」「スキャンから保存・検索までの運用を設計したい」とお考えの場合は、合同会社Edel Hearts のOSS導入支援へご相談ください。弊社で実測した読み違いの傾向を踏まえ、率直にお伝えします。
出典
- Paperless-ngx Docs:Configuration(PAPERLESS_OCR_LANGUAGE・PAPERLESS_OCR_LANGUAGES・PAPERLESS_DATE_PARSER_LANGUAGES)(2026年10月25日確認)
- 公式 docker-compose.postgres.yml(ports が “8000:8000″)(2026年10月25日確認)
- 公式 docker-compose.env(2026年10月25日確認)
- 実測値:2026年10月25日に、弊社の検証サーバー(さくらのクラウド、2コア・8GB・SSD 40GB、Ubuntu 22.04、Docker 29.8.2)で計測。メモリは起動60秒後の全体使用量から、素の状態(262MB)を差し引いて算出。テスト書類には、弊社がフォントを使って作成した架空の請求書・領収書・お知らせ(各きれい版・スキャン風の計6枚)を使用。一致率は空白を除去して NFKC 正規化した文字列について、一致文字数を正解の文字数で割って算出