MetabaseとApache Supersetを比較|同じ2万行の日本語データで実測。日本語化・メモリ・導入の手間【2026年版】
2026-10-29
※2026年10月25日時点の情報です。弊社のサーバーで Metabase v0.64.3.4 と Apache Superset 6.1.0 を動かし、確認しました。画面の翻訳や公式の構成ファイルは版によって異なるため、最新の内容については各公式ドキュメントをご確認ください。
Looker Studio や Tableau に代わる、自分のサーバーで動かせる BI ツール。その候補としてまず挙がるのが、Metabase と Apache Superset です。いずれもオープンソースで、Docker で構築できます。一方、日本語の比較記事には機能表を写したものが多く、同じサーバー・同じデータで動かし、日本語でどこまで使えるのかを確かめた記事はほとんどありません。
そこで弊社では、同じサーバーに2つを1本ずつ立て、同じ2万行の日本語の売上データから同じグラフを作成して比較しました。
結論:日本語ですぐに使うならMetabase、SQLで分析するならSuperset
| こんな使い方なら | おすすめ | 理由 |
|---|---|---|
| エンジニアでない人が、画面をクリックするだけで集計したい | Metabase | 設定1つですべての画面が日本語になり、SQL を書かずに集計できる |
| SQL を書く分析担当がいて、グラフの種類や細かな設定を求めている | Apache Superset | SQL Lab では日本語の列名をそのまま書ける。チャートの設定項目も多い |
| メモリの少ないサーバーに導入したい | Apache Superset | 今回の計測では約840MBで、Metabase(約1.7GB)の半分ほど |
| 導入にかかる手間を最小にしたい | Metabase | 公式の compose 例がほぼそのまま動いた。Superset は公式手順のままでは一部の機能が動かなかった |
- 日本語:Metabase は設定1つで全画面を日本語にできる。Superset は公式イメージのままだと英語で、日本語化には設定の追加と翻訳ファイルの生成が必要
- メモリ:Metabase 約1.7GB(2コンテナ)、Superset 約840MB(5コンテナ)
- 速度:2万行の集計はどちらも0.1〜0.3秒で、この規模では体感できる差はない
- 導入:Superset は公式手順のままではworker が起動を繰り返した。既定の管理者パスワードと SECRET_KEY も差し替える必要がある
検証条件:同じサーバーと同じ2万行の日本語データを使用
使用したサーバーは、さくらのクラウドの2コア・メモリ8GB・SSD 40GB(Ubuntu 22.04、Docker 29.8.2)です。2つを同時に動かすことはせず、1本ずつ立てて計測し、終了後に止めてイメージを消してから次へ進みました。
データには、弊社が作成した架空の売上表を使いました。テーブル名の「売上」に加え、列名の「注文日・都道府県・商品分類・商品名・数量・金額」もすべて日本語です。2026年4月1日〜9月27日の2万行に、7都道府県・3分類(家具・家電・文具)・6商品が含まれています。このデータを PostgreSQL に入れ、両方のツールから接続しました。
画面のポートは、どちらも 127.0.0.1 に限定しています。作成したのは「都道府県別の売上合計(棒グラフ)」と「月別・商品分類別の売上(折れ線)」の2つです。
MetabaseとSupersetの実測比較:メモリ・ディスク・起動時間・速度
| 項目 | Metabase v0.64.3.4 | Apache Superset 6.1.0 |
|---|---|---|
| 構成 | 2コンテナ(metabase+アプリ用 postgres:16) | 5コンテナ(app・worker・worker_beat・postgres:17・redis:7)+初期化用の init |
| Docker イメージ | metabase 1.91GB・postgres 642MB | superset 1.27GB(app・worker などで共用)・postgres 646MB・redis 170MB |
| ディスクの増加 | 3.2GB | 2.1GB |
| 起動から応答まで | 63秒(/api/health が 200) | 59秒(/health が 200) |
| メモリ | 約1.7GB。起動60秒後は metabase 1.62GB・postgres 102MB。集計や画面操作のあとも metabase は 1.66〜1.68GB とほぼ一定 | 約840MB(worker の修正後)。worker 363MB・worker_beat 208MB・app 199MB・postgres 63MB・redis 8MB |
| 都道府県別の合計(API) | 1回目 0.19秒、2回目以降 0.09秒 | 1回目 0.09秒、2・3回目 0.07秒(キャッシュを使わない設定) |
| 画面での表示 | 棒グラフ 107ms、折れ線 95ms | 棒グラフ 0.294秒、折れ線 0.225秒 |
| 画面の日本語 | 設定1つでほぼすべて | 公式イメージのままでは英語 |
メモリに差が出るのは、Metabase が Java(今回は Java 25)で動作し、起動時にまとめてメモリを確保するためです。その後は集計を繰り返しても、ほとんど増えませんでした。Superset はコンテナ数こそ多いものの、1つずつの使用量が小さく、合計すると Metabase の半分ほどになります。
集計の速度は、両方とも0.1〜0.3秒の範囲でした。数値には違いがあるものの、2万行・同じサーバーでの計測では、使っていて差を体感できません。今回は数百万行のデータや、多人数で同時に開く場合の速さを測っていません。この表だけを速度による選定の根拠にはしないでください。
Metabaseの日本語対応:設定1つで編集画面も日本語に
Metabase では、初期設定で表示言語に日本語を選ぶだけで、メニューから案内のダイアログ、クエリの編集画面まで日本語になりました。編集画面には「データ」「集計」「フィルター」「データを結合」「並べ替え」「行数制限」「カスタム列」「可視化」のボタンが並びます。
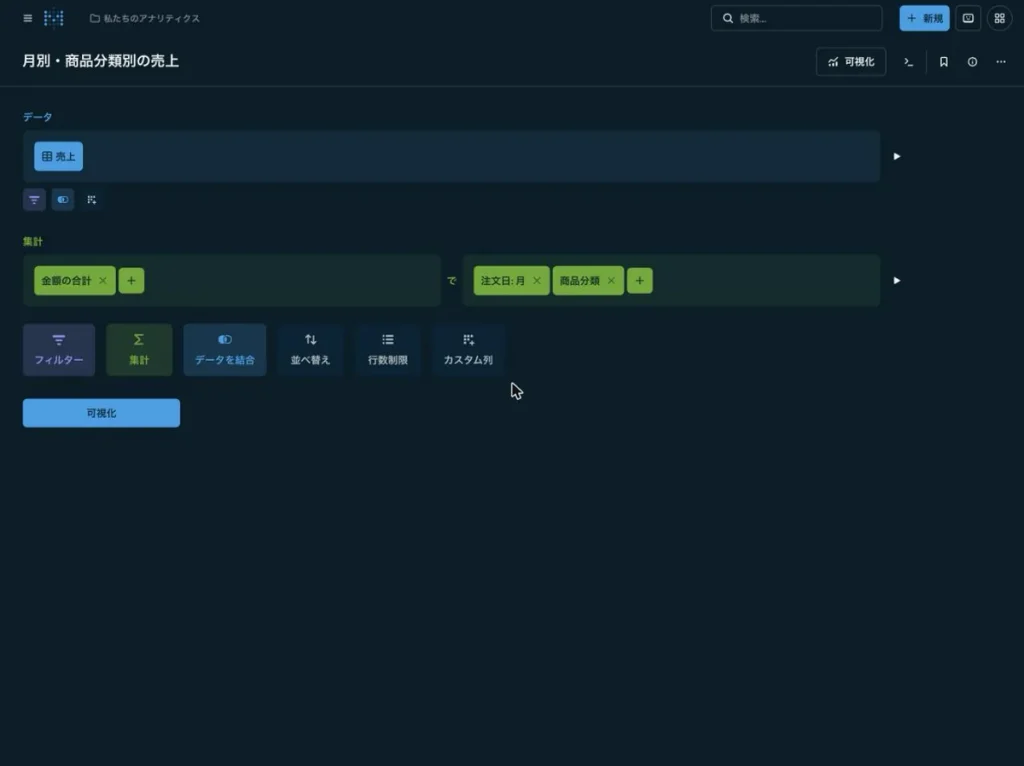
テーブル名や列名に使った日本語は、そのまま画面上の表示名になります。集計した列も「金額の合計」という自然な日本語で表示されました。グラフの軸にある都道府県名や、凡例の「家具・家電・文具」にも文字化けはありません。
一方、月の表記には気になる点がありました。月別の折れ線の軸には、「4月 2026」「5月 2026」と表示されます。日本語でよく使われる「2026年4月」とは順序が異なります。意味は読み取れますが、社内資料にそのまま貼る場合は違和感が残ります。
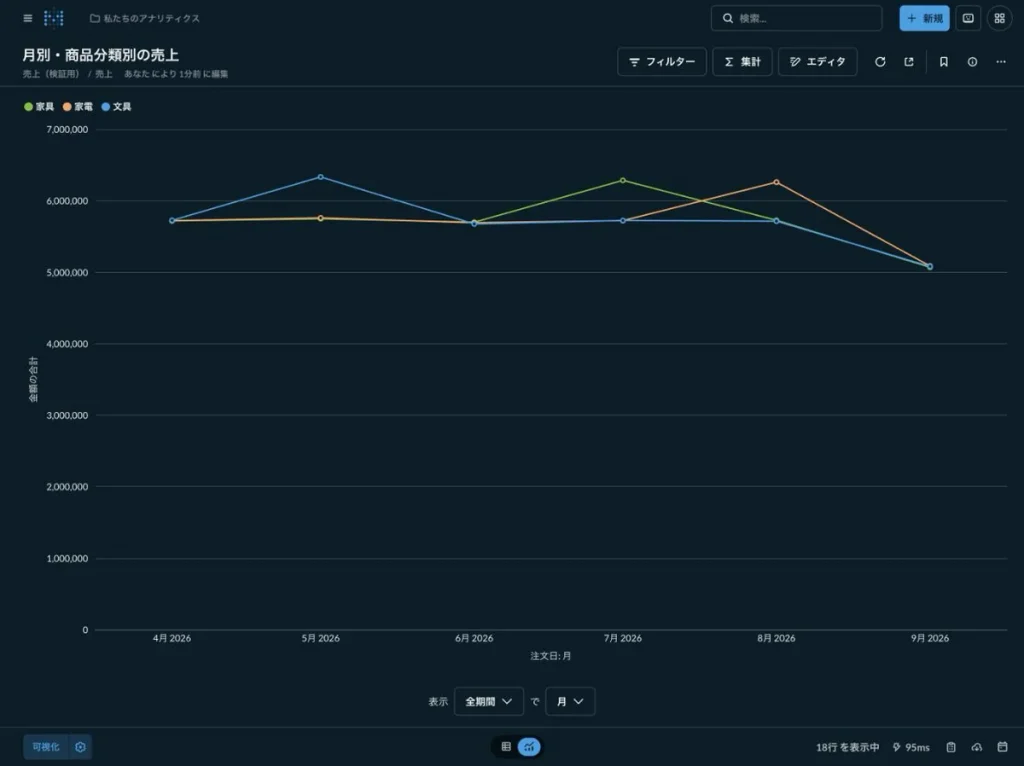
グラフの作成では、データに「売上」、集計に「金額の合計」、分ける軸に「注文日: 月」と「商品分類」を選ぶだけです。SQL を書かず、クリックで集計できるため、エンジニアでない人にも渡しやすい作りになっています。
Supersetの日本語化:公式イメージには画面用の翻訳が含まれない
公式イメージをそのまま起動した Superset は英語表示で、言語の切り替えメニューもありません。設定ファイル(superset/config.py)では、既定値が BABEL_DEFAULT_LOCALE = "en"、LANGUAGES = {}(空)となっているためです。
そこで Docker 用の設定ファイル docker/pythonpath_dev/superset_config_docker.py に、既定の言語を ja、選択可能な言語を日本語と英語にする設定を加えて再起動しました。右上には日本の国旗が付いた言語メニューが現れたものの、ログイン画面は英語のままでした。
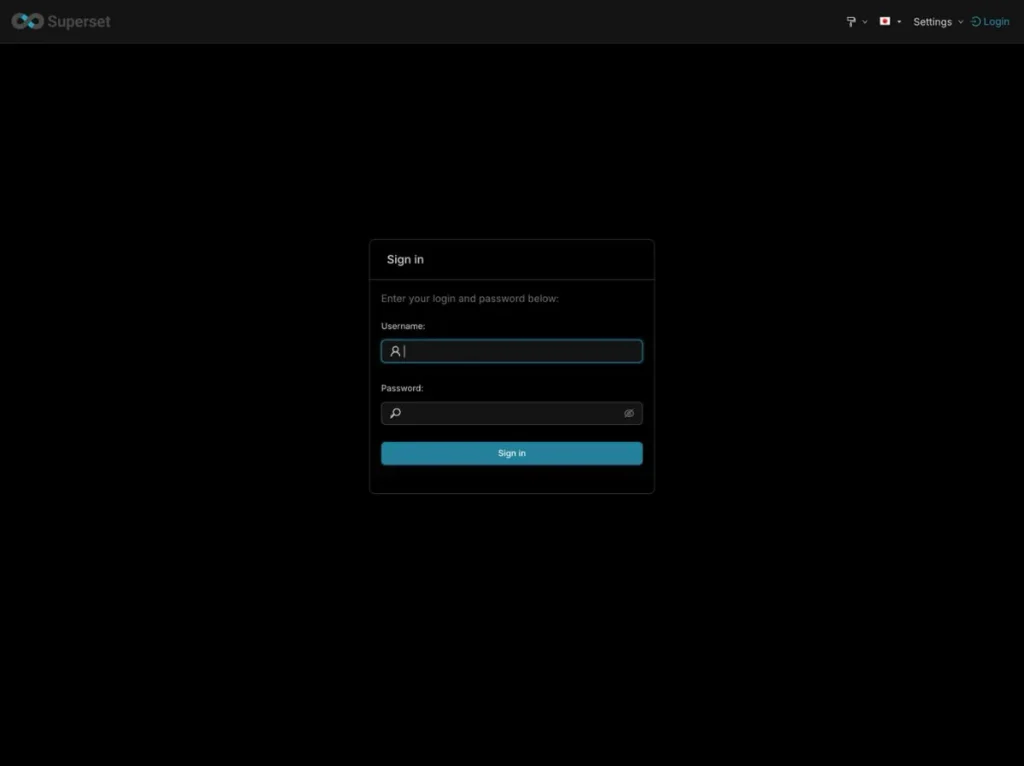
ログイン後のメニューも、「Dashboards」「Charts」「Datasets」と英語で表示されます。調べたところ、公式イメージに含まれるのは翻訳の元ファイル(messages.po)だけで、画面で使う翻訳ファイル(フロント用の messages.json とサーバー用の messages.mo)は生成されていませんでした。ソースからビルドする際に、翻訳も生成することを前提とした構成です。
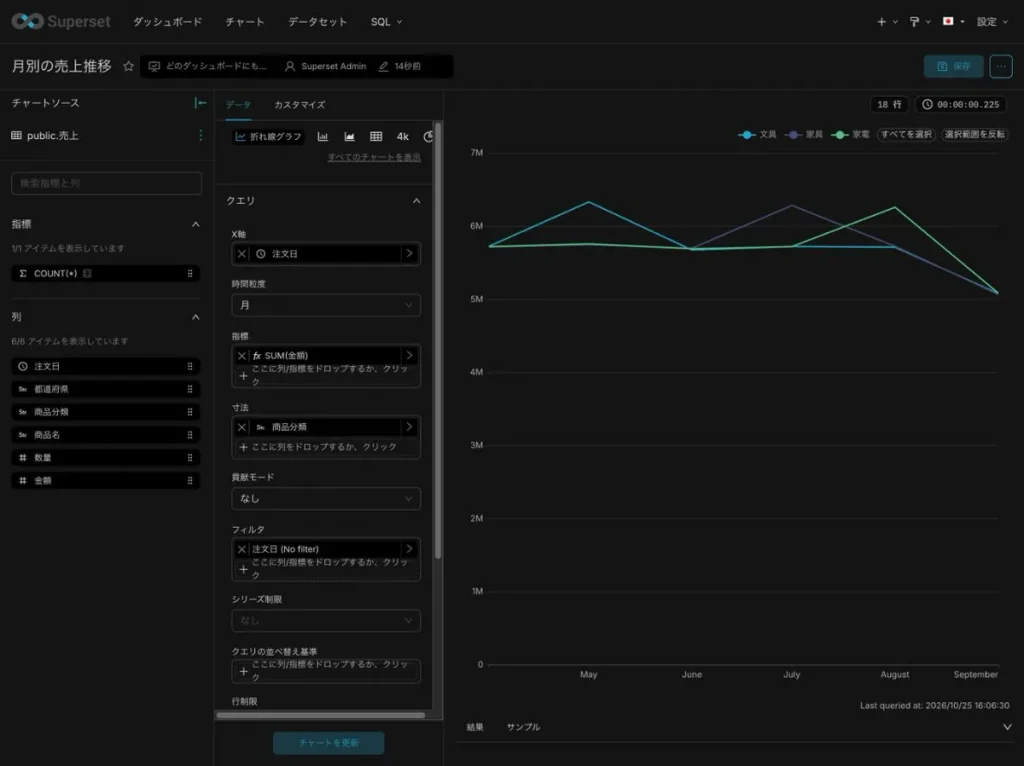
検証ではコンテナ内で .po から .json と .mo を生成し、app を再起動しました。その結果、メニューやチャートの編集画面、SQL Lab はほぼ日本語になりました。
ただし、この対応は検証に限った一時的な処置です。生成したファイルは、コンテナを作り直すと消えてしまいます。本番環境で画面を日本語にするには、翻訳ファイルを含む独自のイメージを作るか、外部から翻訳ファイルをマウントする必要があります。
日本語化のあとにも、次のような英語表記が残りました。
- チャートのフィルタにある「No filter」、グラフ下の「Last queried at」
- SQL Lab の「Untitled Query 1」「Validate query」「Download to client」、スキーマ検索欄の「Enter a part of the object name」
- SQL のエラーの見出し「Unable to parse SQL」
- 月の軸ラベルは「May」「June」…「September」という英語。金額の軸は「16M」「7M」の M 表記
翻訳の元ファイルを数えたところ、日本語は4,594項目のうち4,306項目が訳されており、割合は93.7%でした(参考:ドイツ語 94.1%、中国語 88.1%)。翻訳自体はかなりそろっています。足りないのは、画面用に変換したファイルが含まれていないという点です。
なお、日本語のテーブル名・列名はそのままデータセットに登録でき、集計にも使えました。
導入の手間:Supersetは公式手順のままだと一部が動かなかった
Metabase:公式の compose 例でそのまま動作
Metabase には、公式ドキュメント「Running Metabase on Docker」の docker-compose の例(metabase と、アプリ用の postgres)を使いました。変更したのは、ポートを 127.0.0.1:3000:3000 にした点と、DB のパスワードに生成した値を使った点だけです。この構成で問題なく動作しました。
初期設定は画面のウィザードに沿って進めます(弊社では同じ内容を API で実行しました)。分析対象のデータベースにも、画面でホスト・DB 名・ユーザー・パスワードを入力するだけで接続できます。
Superset:worker の不具合と既定値の差し替えが必要
Superset は公式手順に従ってリポジトリをタグ 6.1.0 で取得し、公開イメージを使う compose ファイル(docker-compose-image-tag.yml)で起動しました。この過程で、2つのつまずきがありました。
1つ目は、worker と worker_beat が再起動を繰り返した点です。ログには No module named 'psycopg2' と出ていました。起動スクリプトは「競合を避けるため worker には PostgreSQL 用のライブラリを入れない」という作りで、app には入るものが worker には入りません。docker/requirements-local.txt に psycopg2-binary==2.9.9 を記載し、worker を再起動すると解消しました。
グラフは worker が止まった状態でも表示できます。しかし、非同期のクエリ、レポート、アラート、サムネイルには worker が必要です。表示の確認だけで「動いた」と判断してしまうと、あとから不具合に気付くことになります。
2つ目は、既定値を差し替える必要があることです。公式の構成をそのまま使うと、以下の設定になります。
| 項目 | 公式の既定 | 弊社の対処 |
|---|---|---|
| ポート | 8088:8088。サーバーの全アドレスで開く |
127.0.0.1:8088:8088 に変更 |
| 管理者パスワード | admin / admin | docker/.env-local で生成した値に変更 |
| SUPERSET_SECRET_KEY | TEST_NON_DEV_SECRET という固定値 | 同じく生成した値に変更 |
Metabase と条件を合わせるため、サンプルデータは読み込まない設定(SUPERSET_LOAD_EXAMPLES=no)にしました。また、公式の docker/.env には DEV_MODE=true、FLASK_DEBUG=true、SUPERSET_ENV=development が設定されています。公式の compose は開発やお試しを想定した構成であり、そのまま本番で使うためのものではありません。
操作のしやすさ:SupersetはBI寄りの用語、SQL Labでは日本語の列名をそのまま書ける
Superset のグラフ作成は、「データセット」の登録から始めます。続いて、X 軸・指標(SUM(金額))・寸法(=分けて表示する列)を、ドラッグ&ドロップまたはクリックで選択します。
「指標」「寸法」「貢献モード」など、画面に使われる用語は直訳に近い表現です。設定項目は豊富ですが、Metabase の「金額の合計 で 注文日: 月」という言い回しと比べると、BI の用語に慣れている人に向いた作りです。
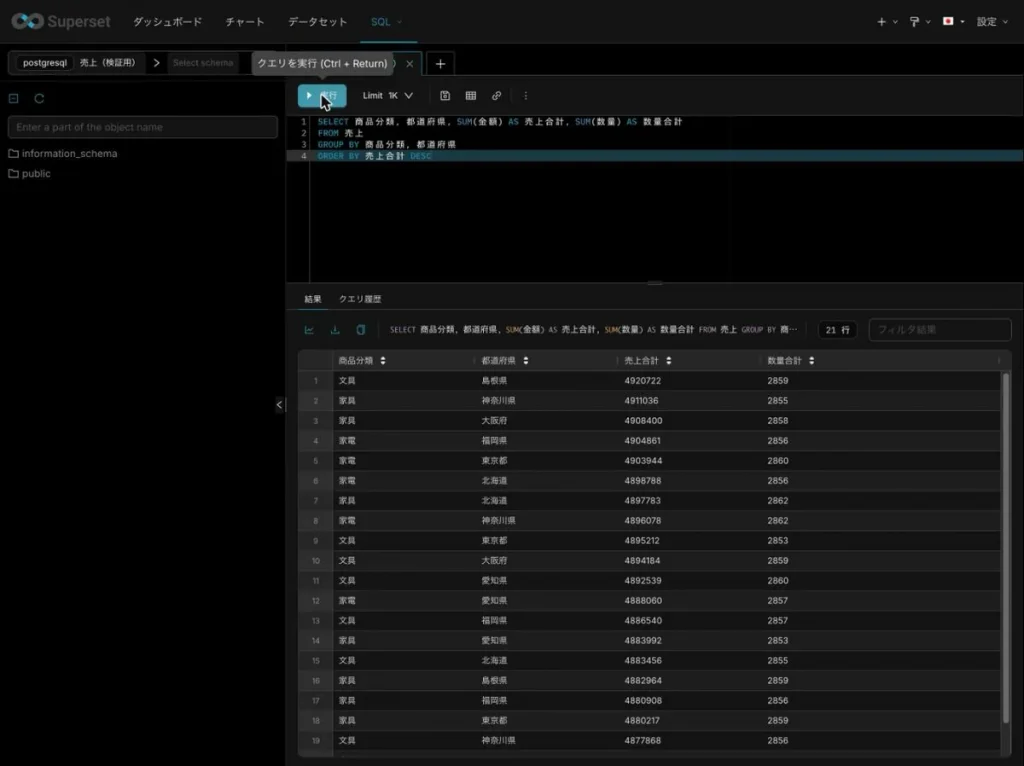
SQL を書く人にとって便利なのが SQL Lab です。日本語のテーブル名・列名を、ダブルクォートで囲まずそのまま書いて実行できました。商品分類と都道府県で GROUP BY する集計(21行)も、1秒未満で結果が返りました。
ただ、エディタの入力補完は強く働きます。改行を交えながら素早く入力すると、補完の語(SELECT や GRANT)が入り込み、SQL が崩れることがありました。長い SQL は別のエディタで書き、貼り付けるほうが安全です。
MetabaseとSuperset、どちらを選ぶか
| Metabase が向いている | Apache Superset が向いている |
|---|---|
| 営業や経理などのエンジニアでない人が、自分で集計したい | SQL を書ける分析担当がいる |
| 日本語の画面を使いたい。翻訳への対応に手間をかけたくない | 英語の画面でも支障がない。または独自イメージを作成・保守できる |
| サーバーのメモリに2GB 前後の余裕がある | メモリの使用量を抑えたい。今回の計測では約840MB |
| Docker の構成をできるだけ単純にしたい(2コンテナ) | レポートやアラートを worker で動かす構成を管理できる(5コンテナ) |
Looker Studio に代わるツールで「社内のみんなが日本語の画面でグラフを見る」なら、弊社の検証では Metabase のほうが少ない手間で使えるという結果になりました。日本語化や構成の調整に対応できる体制があるなら、Superset は SQL を中心とした分析で力を発揮します。
まとめ:MetabaseとSupersetは速度より日本語と導入の手間に違い
- 同じ2コア・8GB のサーバーと、同じ2万行の日本語データを使って比較した
- Metabase は設定1つで画面を日本語にできる。月の軸は「4月 2026」の順に並ぶ
- Superset は公式イメージのままだと英語。翻訳ファイルの生成が必要で、コンテナを作り直すと消える。本番では独自イメージかマウントで対応する
- メモリは Metabase 約1.7GB、Superset 約840MB。ディスクの増加は3.2GB と2.1GB
- 集計にかかる時間はどちらも0.1〜0.3秒。2万行では体感できる差がなく、大きなデータでの速さは未検証
- Superset は公式手順のままでは worker が動かず、管理者パスワード・SECRET_KEY・ポートの修正も必要
Metabase と Apache Superset の概要やライセンスについては、OSSMatch の各ページで随時更新しています。
- Metabase の詳細ページ
- Apache Superset の詳細ページ
- Looker Studio の代わりになるOSS一覧
- Tableau の代わりになるOSS一覧
- BI・データ可視化のカテゴリー
「社内のデータベースに接続して日本語で使いたい」「Superset の日本語化から worker の構成まで含めて組みたい」といったご相談は、合同会社Edel Hearts のOSS導入支援で受け付けています。弊社で実際に2つを立てた際、どこでつまずいたのかを具体的にお伝えできます。
出典
- Metabase Docs:Running Metabase on Docker(docker-compose の例)(2026年10月25日確認)
- Apache Superset Docs:Docker Compose(インストール手順)(2026年10月25日確認)
- Superset 6.1.0 の config.py(BABEL_DEFAULT_LOCALE と LANGUAGES の既定)(2026年10月25日確認)
- Superset 6.1.0 の docker-bootstrap.sh(worker への依存の入れ方)(2026年10月25日確認)
- Superset 6.1.0 の日本語翻訳ファイル(messages.po)(2026年10月25日確認。訳済みの割合は弊社で集計)
- 実測値:弊社の検証サーバー(さくらのクラウド、2コア・8GB・SSD 40GB、Ubuntu 22.04、Docker 29.8.2)で2026年10月25日に計測。1本ずつ起動し、メモリとディスクは素の状態からの増分またはコンテナ別の使用量を記録。データには弊社で作成した架空の売上表(2万行、日本語の列名)を使用